【感想】12のソフトウェア・アーキテクチャの落とし穴とその避け方
はじめに
InfoQ に掲載された記事がとても面白かったので備忘も兼ねて感想を書こうと思う。
以下に記事に記載された著者の主張と感想を記載する。
一人の人間がすべての決定を下したり、影響を与えたりしてはならない。代わりに、適切なチームメンバーに意思決定に参加してもらう。
とはいえ関係者全員が納得するアーキテクチャも存在しないので、各種トレードオフを考慮しながらどういい塩梅に落とし込むかにリーダーの手腕が問われそう。
まずいのは、開発対象のサービスのドメイン知識やコンテキストのない人(エンジニアとしては優秀)たちで構成されたアーキテクチャ委員会みたいな所で意思決定されてしまうことだと思う。
ドメインエキスパートの参加は必須だが、様々な開発のコンテキストを知っている現場のエンジニアも必ず意思決定に関与させるべきだと思う。
再利用の目標が誤った決定を左右するようなことがあってはならない。その代わり、再利用は理にかなった場合のみ行うこと。
行き過ぎた再利用・共通化が技術的負債になるはあるあるだと思う。
この記事では特にアーキテクチャレベルでの再利用はアンチパターンだと主張している。 同意(完全にやめるのも非現実的だとは思う)。
共通化されたサービスが複数のチームで利用されるようになると、技術的な意思決定がチームを跨いでなされるようになり、開発のボトルネックになるため。
アーキテクチャー上の課題に取り組んだ経験のある人材を解雇してはならない。その代わり、彼らを雇用し、必要であれば再教育する。
属人性よくない言われがちだけど、ある程度の属人性を許容することによってそのシステムのコンテキストを熟知した人たちを組織に根付かせること開発コストの削減につながるとは思う。
もちろん暗黙知が非常に多く、新規参画者にとってキャッチアップが困難な状況を作っていいわけでもないので、トレードオフはあると思うが ソフトウェア開発スキルはコモディティであるという信念 に毒されて開発エンジニアを取り替え可能な部品捉えるべきではない(ロックインとのトレードオフ。)。
より早く納品するために品質を妥協してはならない。その代わり、技術的負債(Technical Debt)は、アーキテクチャを実行可能な状態に保つレベルで管理すること。
あとでリファクタリングするよりも最初に高品質なコードを書いた方が断然コスパが良い。
酷いコードのリファクタリングはコストがバカにならず結果としてROIが低くなりがちなので、すでにある技術的負債の返済は「アーキテクチャを実行可能な状態に保つレベル」程度に済ますべき。
「負債=絶対悪」とするのではなく、うまく付き合っている選択をすべき。
アーキテクチャを完璧にするために納品(とフィードバック)を遅らせてはいけない。その代わりに、今ある最高の情報を使ってアーキテクチャを設計し、フィードバックを使ってそれを改善する。
1つ上の項目と矛盾するようだがアーキテクチャに完璧はない。「フィードバックを使って改善」できる状況を作ることを初期アーキテクチャの目標にすべき。
過剰設計は初期開発において陥りがちの罠なので気をつけたい。妥協しないというのは完璧を目指すことではなく、既存環境の制約から来るトレードオフの中で最適値を目指すことである。
誰かが成功させたアーキテクチャを真似してはいけない。その代わりに、独自のQARを使ってアーキテクチャを設計しよう。
書籍や他社事例で言及された「ベストプラクティス」や「アーキテクチャパターン」が必ずしも自組織にとってふさわしいとは限らない。
組織によって発生する制約やトレードオフは異なる。そのため、アーキテクチャ選定はあくまでも自組織の「コンテキスト」を十分に考慮に入れ、教科書上のベストプラクティスだけを盲信して判断しないようにしたい。
ベンダーやコンサルタントに意思決定を委託してはならない。その代わり、自分たちのアーキテクチャを自分たちでコントロールでできるようにしておくこと。
コンテキストを熟知してない人たちに意思決定してはいけないよねって話。ここまで読んだなら詳細は言うまでもないので省略。
社内のソフトウェア・アーキテクチャ・レビューだけに頼らず、できるだけ早く製品をリリースし、実世界からのフィードバックを得ること。
初期設計の段階で最良のアーキテクチャ選定ができるとは限らない。実世界からのフィードバックによってソフトフェアアーキテクチャをブラッシュアップするという視点を持とう。
【備忘】開発チームの自己診断能力の欠如がもたらす弊害と解決策についての考察
背景
筆者はソフトウェア開発チームの一員として日々開発を行なっているが、ここ最近2週間毎に区切っている開発期間に実施すべき開発タスクが未達になってしまう状態が続いている。
いわゆるスプリントゴール未達成ってやつ。
この原因を探り、改善すべく施作を考える必要に迫られているのだが、改めて我々は以下のような質問に回答する術を持っておらず、今後の開発生産性向上ための正確な打ち手を打てないでいる。
- 我々の開発パフォーマンスの良いのか悪いのか?何を持ってパフォーマンス良し悪しの指標とするか?
- 我々の開発パフォーマンス・成果はチーム内外のステークホルダーの期待に添えているか?
- 我々の開発パフォーマンスの期待値設定は適切か?
- もしかしたら開発パフォーマンスが低いのではなく、スプリントゴールの設定に無理があるのではないか?
現状の開発パフォーマンスの正しい把握なしに適切な期待値設定はできない。
また、パフォーマンスの度合いを知る術もないままやれ開発進捗が悪いだのスプリントゴールが達成できていないだのとチーム内で議論をしても、議論は空中戦になってしまう。
結果としてノルマ未達の原因を探るにも、正しく原因や現状を知るためのファクトが何もないまま、根拠なき推測によってのみ仮説が立てられ、NextActionが実行される。
一度本当にあった不幸な事案として、「開発者の開発能力が足りないのでは?」という仮説が立ってしまい、対応案として開発進捗の監視(≒プレッシャー)強化と有識者による開発補助制限(各人のスキルアップのためらしい)という厳しい措置が取られ、チームの雰囲気が悪くなってしまった。
改善策実行結果何が改善されたのかを知る術はもちろんなかった。
課題
- 開発チームの開発生産性を測定する術がない。それによって、
- 一定期間にこなせるタスクを見積りにくい
- 各種ステークホルダー(PM・EM…etc)との開発スケジュールや成果物の期待合意が正確にできない
- 開発成果が期待値を下回った際の原因調査をする術がない。それによって、
- 一定以上根拠のある改善策をTryすることが難しい
- 次回以降の期待値調整を正確に行うことが難しい
- 実行した施作の効果を測定する術がない。それによって、
- 再現性のある施作ない施作の判断ができない
解決策(案)
現状、上記のような問題に対処するために、何かしら開発パフォーマンスを可視化できる指標を立て、それを測定することによって開発のパフォーマンスを継続的に測定する仕組みをつくりたい。
以下、有用メトリクス。
どうやって測るかは検討余地あり。
Four Keys の文脈
Google Cloudの記事より、以下の指標が参考になる。
- デプロイの頻度 - 組織による正常な本番環境へのリリースの頻度
- 変更のリードタイム - commit から本番環境稼働までの所要時間
- 変更障害率 - デプロイが原因で本番環境で障害が発生する割合(%)
- サービス復元時間 - 組織が本番環境での障害から回復するのにかかる時間
Space の文脈
以下の記事より、
- Satisfaction and well-being
- Performance
- Activity
- Communication and collaboration
- Efficiency and flow
開発成果やパフォーマンスを直接測るというよりかは、従業員の満足度やコラボレーションなどの度合いも図り目先の成果以外の通知含めて総合的に測定する試み。
その他参考指標
筆者の所属している開発組織でよく用いられている数値。
開発生産性そのものと、生産性に影響を与えるであろう数値の2つに分類してみた。
生産性そのものとして活用できそう(?)な数値
- デプロイ頻度
- プルリククローズ速度(プルリクリードタイム)
- コード変更頻度
- Rollbackにかかる時間
- 不具合件数
- ベロシティ
- 手戻り率
- リリースにかかる時間
- RollBackにかかる時間
- PBI/SBI 処理のリードタイム
生産性に影響を与えると考えられる数値
- コードカバレッジ
- 循環的複雑度
- PRのコメント数
- E2Eテストにかかる時間(Autify/Magicpod)
- テストカバレッジ
- CI / テスト 実行時間
- 脆弱性件数
- リクエストレイテンシー
- リクエストエラーレート
終わりに
次回以降の記事で以下について考察したい。
- Fourkeys の具体的な活用法
- Space の具体的な活用法
- その他参考指標の
- 収集方法
- 改善活動への活かし方
【防備】Angular学習参考メモ
RxJs周り
qiita.com SubscribeとPipeの違いとかAngular触っててよく分からなくなる箇所について解説されている
並列処理すげえ
hoge(userId) {
  // user取得と会社情報取得は並列で行われます。
  // forkJoinの引数は配列で記述しないと非推奨の警告が出ます。
  forkJoin([
    this.searchUser$(userId),
    this.fetchCompanyInfo$()
  ]).subscribe(data => {
    // user取得処理と会社情報取得処理が両方実行された後、
    // subscribe内の処理が実行されます。
    console.log('user: ', data[0]);
    console.log('company: ', data[1]);
  })
}

// ↓でも結果は同じ
fuga(userId) {
  forkJoin([
    this.searchUser$(userId),
    this.fetchCompanyInfo$()
  ]).pipe(
    // user取得処理と会社情報取得処理が両方実行された後、
    // pipe内の処理が実行されます。
    tap(data => {
      console.log('user: ', data[0]);
      console.log('company: ', data[1]);
    })
  ).subscribe()
}

searchUser$(userId: number): Observable<User> {
  return this.userService.fetchById$(userId);
}

fetchCompanyInfo$(): Observable<Company> {
  return this.companyService.fetchCompany$();
}
テストダブルの原則 ② ~テストダブル利用のテクニック~
テストダブル利用のテクニック
モッキングフレームワーク
モッキングフレームワークはオブジェクトをモック(mock)と置き換えられるようにする。
注意点として使いすぎるとコードの保守が難しくなる点が挙げられる。
// 例)モッキングフレームワーク

class PaymentProcessorTest {
  ......
  PaymentProcessor paymentProcessor;

  // CreditCardServiceのテストダブルをコード1行だけで作成する。
  @Mock CreditCardService mockCreditService;

  @Before public void setUp() {
    // テスト対象システムにテストダブルを渡す。
    paymentProcessor = new PaymentProcessor(mockCreditService);
  }

  @Test public void chargeCreditCardFails_returnFalse() {
    // テストダブルの挙動を定義する
    // どんな引数を与えて呼び出してもfalseが返却される
    when(mockCreditCardService.chargeCreditCard(any(), any()))
      .thenReturn(false);
    boolean success = paymentProcessor.makePayment(CREDIT_CARD, AMOUNT);
    assertThat(success).isFalse();
  }
}
フェイキング
- フェイク(fake):本番環境には適さないが、本物の実装同様に振る舞うAPIの軽量実装。
- 例) メモリ内DB
注意点として、フェイクは現在・将来において本物の実装同様の挙動を保つことを担保しなければならない
// フェイクの作成は高速で容易である
AuthorizationService fakeAuthorizationService = new FakeAuthorizationService();
AccessManager accessManager = new AccessManager(fakeAuthorizationService );

// 不明なユーザーIDはアクセス権を持つべきでない
assertFalse(accessManager.userHasAccess(USER_ID));

// ユーザーIDは、認証サービスへ追加された後はアクセス権を持つべきである
fakeAuthorizationService.addAuthoraizedUser(new User(USER_ID));
assertThat(accessManager.userHasAccess(USER_ID)).isTrue();
スタビング
それ自体では何も挙動を持たない関数に挙動を与えるプロセス。つまり、関数が返すべき正確な値を関数に対して指定すること。指定した返り値を(スタブ)という。
// モッキングフレームワークにより生成されたテストダブルを渡す。
AccessManager accessManager = new AccessManager(mockAuthorizationService);

// nullが返されるユーザーIDはアクセス権を持つべきでない
when(mockAuthorizationService.lookupUser(USER_ID)).thenReturn(null);
assertThat(accessManager.userHasAccess(USER_ID)).isFalse();

when(mockAuthorizationService.lookupUser(USER_ID)).thenReturn(USER);
assertThat(accessManager.userHasAccess(USER_ID)).isTrue();
インタラクションテスト
関数がどのように呼び出されるかを実際に対象の関数の実装を呼び出すことなく検証する手法。
インタラクションテストはテスト対象の内部構造に強く依存するため使いすぎると脆いテストに陥るため、可能なら避けるべき。
AccessManager accessManager = new AccessManager(mockAuthorizationService);
accessManager.userHasAccess(USER_ID);

// verify メソッドがlookupUserメソッドを期待通りに呼び出しているかを検証
verify(mockAuthorizationService).lookupUser(USER_ID);
本物の実装
テストダブルは非常に有用だが、Googleにおいては本物の実装(本番環境向けコードで利用されている実装)をテストに利用することを最優先としている。
モッキングフレームワークを使いすぎると、本物の実装とテストコードの同期がとりにくくなり、リファクタリングが難しくなり、テストが汚染されることになる(詳細は次回の記事にて)。
テストダブルの原則 ① ~概要と導入について~
テストダブルの原則
ユニットテストはコードが複雑になるに連れて、書くのが難しくなってくる。
また、本番のコードがいくつもの外部APIを呼び出していたり、その結果をDBに保存していたりする場合、それらの挙動を本番コードのみのユニットテストだけで再現・担保するのは難しいという課題がある。
上記の課題の解決のためにテストダブルという手法が用いられる。
テストダブルに影響されるソフトウェア開発の概念
- テスト可能性:テストダブルを利用するにはまずコードベースが「テスト可能」になっているべき
- つまりテストは本物の実装をテストダブルと取り換え可能になっているべき
- 応用性:テストダブルを不適切に応用するとかえってテストが脆く、複雑になる
- 状況によって本物の実装の利用を優先すべき時もある
- 忠実性:テストダブルの挙動を置き換え対象の本物の実装の挙動とどれだけ近いところに似せられているか
テストダブルの利用と本物の実装の利用には往々にしてトレードオフが存在する。 状況やユースケースに応じて適切な方を選択すべき。
→ 迷ったらまずは本物の実装を利用してみた方がよい。
Googleでのテストダブル
テストダブルは適切に使用すれば生産性とソフトウェア品質に多くのメリットをもたらすが、府積雪に利用されるとデメリットも多い。
教訓
- モッキングフレームワークを利用しすぎるのは危険。
- バグの検出率が下がる
- テストの保守が大変
結果として、モッキングフレームワークよりも実際の実装をテストに利用することをゆうせんするようになった。
テストダブルの基本概念
テストダブルの例
例 )クレジットカード決済処理を必要とするeコマースサイトを想定したコード例、、
class PaymentProcessor {
  private CreditCardService creditCardService;
  ......
  boolean makePayment(CreditCard creditCard, Money amount) {
    if (creditCard.isExpired()) { return false; }
    boolean success =
      creditCardService.chargeCreditCard(creditCard, amount);
    return success;
  }
このケースでは、テスト内で本物のクレジットカードサービスを利用することは不可能。
そのため、本物のシステムの挙動をシミュレーションするために、代わりにテストダブルを利用する。
// 簡易的なテストダブル
class TestDoubleCreditCardService implements CreditCardService {
  @Override
  public boolean chargeCreditCard(CreditCard creditCard, Money ammount) {
    return true;
  }
}
// テストダブルの利用
@Test public void cardIsExpired_returnFalse() {
  boolean success = paymentProcessor.makePayment(EXPIRED_CARD, AMOUNT);
  assertThat(success).isFalse();
}
この例では、本番コードの挙動はクレジットカードサービスに依存していないため、クレジットカードの有効期限が切れた場合のテストを適切に行える。
シーム
テスト可能:コードは、そのコード向けにユニットテストを書けるような形式で書かれている場合に、テスト可能であるといえる。
シーム:テストダブルを利用できるようにすることで、コードをテスト可能とする手法
- ディペンデンシーインジェクションは、シームを導入する一般的なテクニックである。
// ディペンデンシーインジェクション
class PaymentProsessor {
  private CreditCardService creditCardService;

  PaymentProsessor(CreditCardService creditCardService) {
    this.creditCardService = creditCardService;
  }
}
// テストダブルを渡す
PaymentProessor paymentProessor =
  new PaymentProcessor(new TestDoubleCreditCardService());
テスト可能なコードを書くには先行投資が必要。
テスト可能性は考慮があとになるほど、コードベースへの適用が難しくなる。
そのため、テスト可能性の実現は、特にコードベースの存続期間の初期に、決定的な重要性を持つ。
【忘備】Terraform基本構文 ~外部から変数値を与える~
変数の上書き方法
外部から変数値を与える方法は3種類
- 環境変数:環境変数へあらかじめ設定してある値を利用
TF_VAR_【Name】
- 変数ファイル:あらかじめ決められた変数ファイル名のファイルに指定
terraform.tfvars
- コマンド引数:以下のコマンド引数で指定された値を利用
-var 【NAME】=【NAME】-var-file【FILE_PATH】
3種類の方法で同じ変数を並行して指定することも可能。
ただしその際は環境変数 < 変数ファイル < コマンド引数の順で上書き(強い)される。
また、同じ方法で変数の定義が重複した場合は原則として後に定義した変数が優先(つまりあと勝ち)される。
環境変数を使った上書き
ソースコード(main.tf)
variable "message" {
  type   = string
  default = "nothing"
}
環境変数定義、ビルド実行
export TF_VAR_message="Hello World !"
terraform apply
変数ファイルを使った上書き
ソースコード
variable "message" {
  type   = string
  default = "nothing"
}
変数ファイル(terraform.tfvars) ※ 変数ファイルの拡張子は".tfvars"
message = "Hello World!"
ビルド実行
terraform apply
コマンドを使った上書き
ソースコード(main.tf)
variable "message" {
  type   = string
  default = "nothing"
変数を指定したコマンド実行
terraform apply -var message="Hello World!"
変数の上書き使い分け
【忘備】イーサリアム基礎 ~Web3 (js) とは何か~
Web3とは何か
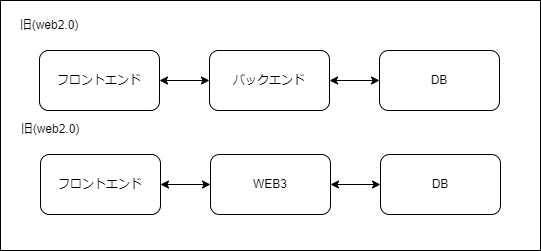
フロントエンド、Web3、ブロックチェーン
イメージ。フロントエンドがWeb3を使ってブロックチェーンに接続する。
プロバイダ
Web3のプロバイダは、、
Dappでは次のようにweb3を呼び出し、アプリケーション用のプロバイダを設定し、ユーザーがブロックチェーンとやり取りできるようにする。
web3.setProvider(new web3.providers.HttpProvider('http://localhost:8545'))
web3インジェクションのためのMetaMask
MataMaskは、、
DappがWeb3を用いてブロックチェーンに対して何かしらの情報を読み書きする際に、、
- 読み書き用のWeb3メソッドはユーザーに対し、MetaMaskを用いてトランザクション署名とガス手数料の支払いを要求する。
【忘備】Terraform基本構文 ~変数とデータ型~
変数
HCL2で利用可能な変数は2種類
- locals : ローカル変数。プライベートな変数で外部から変更はできない。
- variables : 外部から変更可能な変数。コマンドライン実行時にオプションやファイル指定で上書きできる。
locals の定義と参照
「localsブロックで」定義して「${local.【Name】}」で参照
locals {
  project = "testylog"
  env     = "dev"
}

resource <RESOURCE_TYPE> <RESOURCE_NAME> {
  ...
  tags = {
    Name = "${local.project}-${local.env}-vpc"
  }

  output<OUTPUT_NAME> {
    ...
  }
}
variablesの定義と参照
「variableブロック」で変数を1つ定義し、「${var.【NAME】}」で参照
variable "project" {
  type    = string
  default = "tastylog"
}

resource <RESOURCE_TYPE> <RESOURCE_NAME> {
  ...
  tags = {
    Name = "${var.project}-dev-vpc"
  }

  output<OUTPUT_NAME> {
    ...
  }
}
データ型
HCLで扱えるデータ型、
- プリミティブ
- string : Unicode文字列
- number : 数値。整数と少数の両方を表現
- bool : true/falseの2つ
- 構造体
- object : キーバリュー型データ
- tuple : 各列の方が決まっている配列
- コレクション
- list : 特定の方で構成される配列
- map : キーが文字列の配列
- set : 値の重複がない配列
プリミティブ
基本となるデータ型
variable "message" {
  type    = string
  default = "Hello World"
}

variable "max_count" {
  type    = number
  default = 10
}

variable "is_enable" {
  type    = bool
  default = true
}
Object
キーバリュー形式で定義されるデータ型。キーごとに方の定義が可能。
variable "obj_sample" {
  type = object({
    name = string
    age  = number
  })
  default = {
    name = "tabaka"
    age  = 28
  }
}
username = var.obj_sample.name
tuple
配列のN番目にどういった型を使うかが決められたデータ型。下の例だと0要素目が文字列、1要素目が数値。
variable "tuple_sample" {
  type = tuple([
    string, number
  ])
  default = ["tanaka", 28]
}
username = var.tuple_sample[0]
list
すべて同じ型で定義される配列
variable "list_sample" {
  type   = list(string)
  default = ["tanaka", "sato"]
}
username = var.list_sample[0]
map
キーが文字列、バリューが指定された方となる配列。
variable "map_sample" {
  type = map(string)
  default = {
    "High" = "m5.2xlarge"
    "Mid"  = "m5.large"
    "Low"  = "t2.micro"
  }
}
instance = var.map_sample.High
set
バリューの重複が排除される配列
variable "set_sample" {
  type = set(string)
  default = [
    "tanaka",
    "sato",
    "tanaka",
    "sato"
  ]
}
[for itm in var.set_samle : itm]

→ toset([
    "sato",
    "tanaka"
  ])
【忘備】グーグルのソフトウェアエンジニアリング ~ ユニットテスト ③ -明確なテストを書く- ~
明確なテストを書く
まず、初めに申し上げておきたいのはテストの失敗は良いことである。
なぜなら、失敗したテストは、エンジニアに有用なシグナルを提供し、ユニットテストが価値を提供する方法のうち主要なものだからである。
テストの失敗理由
テストの失敗理由は大きく以下の2つ
- テスト対象システムに問題があるか、システムが不完全である。テストは本来このことを検証するために書かれる。
- テスト自体に欠陥がある。失敗しているテストが既存のテストであればそのテストが脆いことを意味する。
原因究明の容易さはテストの「明確性」に依存する
- 明確なテスト:テストの失敗理由と存在理由がエンジニアから見て明確なテスト。
- 特に、当該機能及びテストの実装に関わっていないエンジニアにとってもわかりやすいこと。
明確なテストには、、以下の利点もある。
- テスト対象システムをドキュメント化する
- 新しいテストの基礎の役目果たす
以下、簡潔なテストを書くための原則を紹介する。
テストは完全かつ簡潔にせよ
- 完全なテスト:そのテストがどのようにその結果に到達するのか理解するために必要な全情報を含んでいる。
- 簡潔なテスト:他の紛らわしいか無関係な情報を含んでいない。
上記二点の性質は「コード共有」をめぐる考え方にも関連している。
特に、より明確なテストはDRY原則に反していることが多い。(なぜだろう?各テスト毎に必要な情報を全て含ませる、、定義するから?)
まとめると、テスト本体は重要でない情報や紛らわしい情報を全く含まずに、テストを理解するのに必要な情報をすべて含むべきである。
例)完全で簡潔なテスト
@Test
public void shouldPerformAddition() {
  Calculator calculator = new Calculator();
  int result = calculator.calculate(new Calculation(2, Operation.PLUS, 3));
  assertThat(result).isEqualTo(5);
}
メソッドではなく挙動をテストせよ
メソッドごとにテストを書くと、、 メソッドが複雑になるにつれてテストも複雑になり、実際は何をやってるかわからなくなる。
故に、テストは挙動向けに書くべきである。
[Q.] なぜ挙動向けにテストを書くと、テストが明確になるのか?
- 頭の中で複雑な構文解析しなくてよくなる。
- 原因と結果が分かりやすい
- 各テストが説明的なのでどの機能がすでにテストされているかわかりやすい。
挙動を強調するようにテストを構成せよ
全ての挙動のテストは3つの部分に分けられる
- 前提条件(~という前提条件で)
- 動作定義(~の場合は)
- 結果検証(その場合は~になる)
例)うまく構成されたテスト
@Test
public void transferFundsShouldMoveMoneyBetweenAccounts() {
  // 1. 最初の残高が150ドルと20ドルの口座があるという前提条件で
  Account account1 = new AccountWithBalance(usd(150));
  Account account2 = new AccountWithBalance(usd(20));

  // 2. 第一の口座から第二の口座へ100ドルを送金する場合
  bank.transferFunds(account1, account2, usd(100));

  // 3. その場合は、細心の口座残高は送金結果を正しく反映すべきである
  assertThat(account1.getBalance()).isEqualTo(usd(50));
  assertThat(account1.getBalance()).isEqualTo(usd(120));
}
複数ステップのテストを書く場合は2. と 3. を交互に定義しても良い
ただし、うっかり複数の挙動を同時にテストしてないか注意する必要がある。
テストされる挙動にちなんでテストを命名せよ
- (bad) メソッド志向のテスト:メソッドにちなんで命名される。
- 「testUpdateBalance」みたいなテスト名
- (good) 挙動駆動のテスト:挙動にちなんで命名。より柔軟。
- テスト名称は失敗のリポート内で目に見える数少ない手がかりを提供する。
- 故に、テスト名は冗長であってもそれが正当化される。
- テスト名称は失敗のリポート内で目に見える数少ない手がかりを提供する。
優れたテスト名は、
- システムに対して行われる動作と期待結果の両方を表す
- テストの挙動を要約する
注意すべきは、テスト名称に「また(and)」という単語が出てきた場合、複数の挙動をテストして いる可能性があるためテストを分けた方がよいかもしれない。
describe("情報", function(){
  describe("正の数に",  function() {
    var positiveNumber = 10;
    it ("別の正の数を乗ずると正の数になる", function() {
      expect(positiveNumber * 10).toBeGreaterThan(0);
    });
    it ("負の数を乗ずると負の数になる", function() {
      expect(positiveNumber * -10).toBeLessThan(0);
    });
  })
});
テストにロジックを入れるな
基本、各テストが取り扱ってよいのは「入力セット」だけ。
テストにロジックが入っていると、以下のような問題が発生する。
- テストのロジックの正しさはどうやって検証・担保する?
- テストのテスト書く・・・?
特に気を付けたいのは、期待結果を表現するため等にテスト内で文字列の連携とかやりがちだがこれはテスト内のロジックに該当する。
例)コードに潜むバグを隠すロジック
@Test
public void shouldNavigateToAlbumsPage() {
  String baseUrl = "http://photos.hogehoge.com/";
  Navigator nav = new Navigator(baseUrl);
  nav.goToAlbumPage();

  // baseUrlの末尾に/が入っていておかしくなるが気づきにくい。
  assertThat(nav.getCurrentUrl()).isEqualTo(baseUrl + "/albums");
}
@Test
public void shouldNavigateToPhotosPage() {
  Naigator nav = new Navigator("http://photos.hogehoge.com/");
  nav.goToPhotosPage();
  assertThat(nav.getCurrentUrl()).isEqualTo("http://photos.hogehoge.com//albums"); // お、、
}
明確な失敗メッセージをかけ
失敗メッセージは、テストの明確性の最後の要素 →テスト失敗時にエンジニアは何を見るか。
良いテストメッセージは、、
- 期待結果が明確に表現されている
- 実際の結果が明確に表現されている
- 関連する原因が明確に表現されている
また、失敗メッセージは失敗しているテストの重要な情報を手動で特定することが可能であるべき。
【忘備】Angular チートシート
nodeバージョン切り替え(n)
$ sudo n list
node/12.18.2
node/14.15.4

$ sudo n 14.15.4
新規プロジェクト作成
$ ng n <project-name>
コンポーネント作成
$ ng g component <directory/component-name> --routing
モジュール作成
コンポーネントをまとめてモジュールとして定義できる。
$ ng g module <directory/module-name>
こんなかんじでコンポーネントまとめておく。
import { NgModule } from '@angular/core';
import { CommonModule } from '@angular/common';
import { SidebarComponent } from './components/sidebar/sidebar.component';
import { HeaderComponent } from './components/header/header.component';

@NgModule({
  declarations: [
    SidebarComponent,
    HeaderComponent
  ],
  imports: [
    CommonModule
  ],
  exports: [
    SidebarComponent,
    HeaderComponent
  ]
})
export class CoreModule { }
app.module.ts (ルート)から読み込むと、呼び出したいhtmlに<app-sidebar></app-sidebar>みたいな感じで記載すると呼び出せる
import { BrowserModule } from '@angular/platform-browser';
import { NgModule } from '@angular/core';

import { AppRoutingModule } from './app-routing.module';
import { AppComponent } from './app.component';
import { CoreModule } from './core/core.module';

@NgModule({
  declarations: [
    AppComponent,
  ],
  imports: [
    BrowserModule,
    AppRoutingModule,
    CoreModule
  ],
  providers: [],
  bootstrap: [AppComponent]
})
export class AppModule { }
サービス作成
$ ng g service <directory/service-name>
モデル(任意のクラス)作成
モデルクラス作るときとかに使うかな
$ ng g class <directory/service-name>
(例)
$ ng g class models/user
パイプ(pipe)作成
例として、コメント日付をフォーマットするパイプ(comment-date パイプ)を作成
$ ng g pipe pipes/comment-date
pipes 配下にcommentDateクラスができるので、「transform」メソッドを以下のように書き換える。
@Pipe({
  name: 'commentDate'
})
export class CommentDatePipe implements PipeTransform {

  transform(value: number, ...args: string[]): string {
    const format = args[0] || 'yyyy年MM月dd日 HH:mm'
    return formatDate(value, format, 'en-US');
  }

}
html側では以下の感じで呼び出す。comment.dateの中に返還対象の日付が入っている。
<div>{{ comment.date | commentDate }}</div>
コメントクラスはこんな感じ
export class Comment {

  date: number;

  constructor(public user: User, public message: string) {
    this.date = Date.now();
  }

}
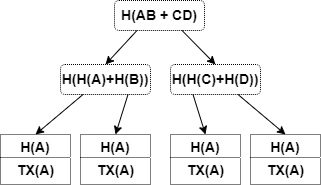
ブロックチェーン基礎 ~ ブロックチェーンの構造 ~
ブロックチェーンとは
ブロックチェーン:ブロックがチェーンのようにつながったデータ構造
ハッシュポインタ:データブロック自体のハッシュ値。前伊のデータブロックを指す。
- データが改ざんされていないことを検証する手段を提供する。
→ ハッシュポインタを用いてブロック同士を繋げてブロックチェーンを作る
イメージ図と解説
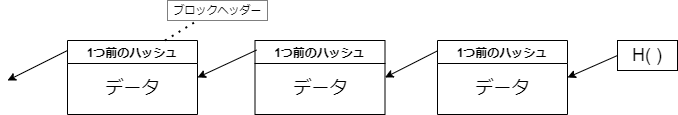
- どのブロックのブロックヘッダーも1つ前のブロックのハッシュ値が格納されている
- どれか1つのブロックを改ざんすると以後のヘッダーのハッシュ値が合わなくなるので改ざんがばれる
- 全ノードがこのブロックチェーンのコピーを持っているので改ざんするにはシステムのノードの過半数をクラックする必要がある
上記 1. 2. 3. の理由によりブロックチェーンの改ざん困難性が実現されている。
【忘備】グーグルのソフトウェアエンジニアリング ~ ユニットテスト ② -脆いテストを防ぐ- ~
- 脆いテスト: バグのない無害かつ無関係な変更で壊れるてすと。
変化しないテストを目指す
脆いテストを防ぐため、理想的には「変化しないテスト」を目指す。
→ 仕様変更以外の理由で変更しないテストのこと。
プログラム変更の要因
ここではテスト変更の要因のことを言っているわけではないことに注意。
純粋なリファクタリング
- 内部構造のリファクタリングのテストは、既存の仕様や振る舞いに影響を与えていないことを保証しているべき。
- よって既存のテストへの変更が入ることは不適切。
バグ修正
- バグの存在は既存のテストコードにおけるケース漏れを意味する。
- よって抜けていたテストケースの追加はあるものの、既存のテストへの変更が入ることは不適切。
新機能
- 原則、新機能追加は既存機能の動作変更を伴うべきではない。
- よって、リファクタリング同様新機能追加時に既存のテストへの変更が入ることは不適切である。
システム仕様・挙動の変更
- テストによって担保されるべき挙動が変更されるので、この場合は既存テストへの変更が入る。
理想としては、システムを拡張する際には
これまでに書かれた全テストをいじらなければならない可能性があるわけではなく、行っている変更に関連する少数の新しいテストのみ書けばよい
状態にしておくべき。
公開APIに対するテスト
理想的にはテストは、要件が変化しない限りテストも変化しないことが望ましい。
テストの実装としては、、
- テスト対象システムのユーザーが呼び出す方法と同じ方法でテストコードでもシステムを呼び出すコードを書く必要がある
- つまり、プログラムの公開APIに対する呼び出しを行う
例1)テスト対象コード
public void  processTransaction(Transaction transaction {
  if (isValid(transaction)) {
    saveToDatabase(transaction);
  }
}

private boolean isValid(Transaction t) {
  return t.getAmount() < t.getSender().getBalance();
}

private void saveToDatabase(Transaction) {
  String s = t.getSender() + "," + t.getRecipient() + "," + t.getAmount();
  database.put(t.getId(), s);
}

public void setAccountBalance(String accountName, int balance) {
  // 残高(balance)を直接データベースに書き込む。
}

public void getAccountBalance(String accountName) {
  // アカウント残高を確定するためにデータベースからトランザクションを読み込む
}
このコードをテストするのが以下のコードである
@Test
public void emptyAccountShouldNotBeValid() {
  assertThat(processe.idValid(newTransaction().setSender(EMPTY_ACCOUNT))
    .isFalse();
}

@Test
public void shouldSaveSerializedData() {
  processer.saveToDatabase(newTransaction()
    .setId(123)
    .setSender("me")
    .setRecipient("you")
    .setAmount(100));
  assertThat(database.get(123).isEqualTo("me,you,100));
}
このテストはテストコードからの呼び出しと、実際のユーザーからの呼び出しとではかなり違う形でやり取りしている。
このテストはシステム(テスト対象コード)の内部状態をのぞき込んで依存している(privateメソッドの中身までテストしている)ので、このテストは脆くなっている。
例3)公開APIのテスト
@Test
public void shouldTransferFunds() {
  processor.setAccountBalance("me", 150);
  processor.setAccountBalance("you", 20);
  processor.processTransaction(newTransaction()
    .setSender("me")
    .setRecipient("you")
    .setAmount(100));
  assertThat(processor.getAccountBalance("me")).isEqualTo(50);
  assertThat(processor.getAccountBalance("you")).isEqualTo(120);
}

@Test
public void shouldNotPerformInvalidTransactions() {
  processor.setAccountBalance("me", 50);
  processor.setAccountBalance("you", 20);
  processor.processTransaction(newTransaction()
    .setSender("me")
    .setRecipient("you")
    .setAmount(100));
  assertThat(processor.getAccountBalance("me")).isEqualTo(50);
  assertThat(processor.getAccountBalance("you")).isEqualTo(20);
}
このテストは、例1の公開API(パブリックメソッド)のみテストしている。このようなテストは実際のシステムの呼び出し側のコードと同じようなやり方でテスト対象コードにアクセスしている。
故に、このテストが破綻するときはシステムの既存ユーザー側の呼び出し元も破綻している場合のみのため、このテストは脆くない。
ユニットテストの適切な範囲の指針
「ヘルパークラス」のような別クラスの支援のためのクラスは支援対象のクラスを通じてテストすべき。
- ヘルパークラスを直接テストすべきではない(脆い)。
だれでもアクセス可能なように設計されているクラス(Utilクラス等)は直接テストされるべき
アクセスに制限があるが、特定の文脈で有用な機能を提供するクラス(サポートライブラリ)も直接テストされるべき。また、そのユーザー(使用箇所)へのテストもすべき。
真理
公開APIへのテスト > 実装詳細のテスト
- システムに対してある変更(仕様や挙動に関する)が起きたときのみテストを失敗させたい。
privateメソッドやヘルパークラスへのテストは脆い
- 特定の仕様や振る舞いの内部構造に癒着(強く依存)したテストのため
相互作用ではなく状態をテストせよ
【忘備】イーサリアム基礎 ~ イーサリアム仮想マシンとコード実行 ② -コントラクト実行詳細- ~
スマートコントラクト作成から利用まで
動作フロー
動作結果
コントラクト利用
EVMのメモリ管理
EVMでは以下の3つの領域に適したメモリ管理を行っている
ストレージ
- Key/Value 型 (256bit)
- 列挙不可
- コントラクトの状態は「ストレージ」にある。(状態変数)
- ストレージはコントラクト作成時に設定され、変更不可。
- ただし、「sendTransaction」関数で変更可能
- ストレージはコントラクト作成時に設定され、変更不可。
- ストレージ読み書きコストが高い
- コントラクト自身が所有していないストレージはアクセス不可。
- SSTORとSLOADはよく使う命令。
メモリ(揮発性)
- 一時的な値を格納
- コントラクトで使ったメモリは実行完了後にクリアされる
- 実行中の出力はストレージにプッシュされるので利用可
- バイト配列
- 空から始まり、32バイト単位で領域が確保される
- 変数宣言時に「memory」キーワード使わないとストレージに変数の領域が確保される
- MSTORとMLOADはよく使う
- メモリはスマートコントラクトのレベルでは使用不可。メソッドでのみ利用できる。
- 関数の引数はほぼメモリをとる
スタック
- EVMはスタックベース
- MAX1024個の要素が入る。
- スタックエントリーも256ビットワード。
- スタック捜査のほとんどはスタックの最上部に限られる。
EVMバイトコード
EVM上のトランザクションのバイトコードは次のタプルに定義される
[block_state, transaction, message, code, memory, stack, pc, gas]
